ComfyUI 워크플로를 API로 만들 때 Comfy API에 맡기는 쪽과 Runpod Serverless에 직접 올리는 쪽은 준비할 일, 요청 하나를 기다리는 시간, 요청당 비용이 얼마나 다를까요? 실제로 쓰고 있는 MiniMax H3 얼굴 교체 워크플로를 두 곳에 똑같이 올리고, RTX PRO 6000 96GB 한 장에서 cold 3회와 warm 5회씩 요청을 보내 비교했습니다.
결론부터 말하면 warm 요청은 Comfy API가 약 30초 빨랐는데요. 로그를 열어 보니 생성 단계(스텝당 33초)는 두 곳이 똑같았고, 차이는 그 앞뒤 처리와 배정된 GPU 서버에서 났습니다. 비용은 GPU 단가가 정확히 1.3배 차이 났지만, 생성이 빨랐던 덕분에 요청당 차이는 그보다 작았죠.
같은 그래프를 두 곳에 올린 방법
워크플로는 MiniMax H3 Ref2VA에 Turbo4 LoRA를 붙여, 5초짜리 인터뷰 영상(1344×768, 124프레임)의 얼굴과 머리만 다른 인물로 바꾸는 그래프입니다. 노드 18개가 모두 ComfyUI 기본 노드이고, 모델은 다섯 개, 합계 약 42GB입니다. Runpod 쪽은 이 워크플로를 위해 직접 만들어 운영하던 이미지와 핸들러를 그대로 썼습니다.
| Comfy API | Runpod Serverless (직접 구축) | |
|---|---|---|
| 올리는 단위 | Build → Release → Deployment | Docker 이미지 → Endpoint |
| 모델 위치 | Comfy의 network storage | Runpod 비공개 Hugging Face 캐시 |
| 요청 방식 | v2 API, 입력 파일은 assets로 업로드 | /run, 입력·출력 모두 base64 |
| 설정 | RTX PRO 6000, min 0 / max 1 | RTX PRO 6000, min 0 / max 1, idle 5초 |
두 곳에 보낸 그래프는 출력 MP4에 남은 실행 그래프를 비교해 확인했습니다. 파일 이름, 저장 경로, 시드를 빼면 18개 노드의 설정이 완전히 같았고, ComfyUI 버전도 같은 커밋(5cc4b870)으로 맞췄습니다. 측정은 2026년 10월 19일 저녁에 한 번에 진행했습니다.
Comfy API 준비에서 손이 간 곳
Comfy API는 2026년 9월 30일에 나온 Comfy Org의 관리형 배포 서비스입니다(Comfy API 출시 소개 글). Runpod은 Comfy API 백엔드 인프라에 참여하는 출시 협업 파트너이기도 합니다. 이번에는 웹 콘솔 대신 comfy CLI 1.22.0으로 진행했습니다.
comfy build init --from-workflow에 API 형식 워크플로를 넣으면 Build 스펙이 만들어지는데요. 처음 만들어진 스펙에는 모델이 0개였습니다. CLI는 모델 네 개가 “공용 카탈로그에 있지만 출처를 직접 넣어야 한다”고 알려 줬고, 영상 VAE 하나는 출처를 찾지 못했습니다. 이때 후보로 제시한 파일은 VAE가 아니라 다른 모드의 확산 모델이었습니다.
comfy build refs resolve로 다섯 파일의 출처를 찾자 모두 공식 Comfy-Org/MiniMax-H3 저장소가 1순위로 나왔습니다. 다만 영상 VAE 후보에는 이름만 같고 크기가 다른 파일이 다른 저장소에서 섞여 나와서, 공식 저장소 것을 직접 골라 넣었습니다.
스펙을 채운 뒤에는 Release 만들기(39.2GB 이미지)에 6분 35초, Deployment 준비에 약 4분 25초가 걸렸습니다. 배포 시간 중 약 3분은 모델 39.1GB를 스테이징하는 데 썼습니다.
Runpod 쪽은 이 비교 전에 만들어 둔 엔드포인트라 같은 기준의 준비 시간은 재지 않았습니다. 대신 이미지 빌드, 모델 캐시, 핸들러 작성을 모두 직접 했다는 차이가 있습니다.
같은 시드로 나온 거의 같은 결과
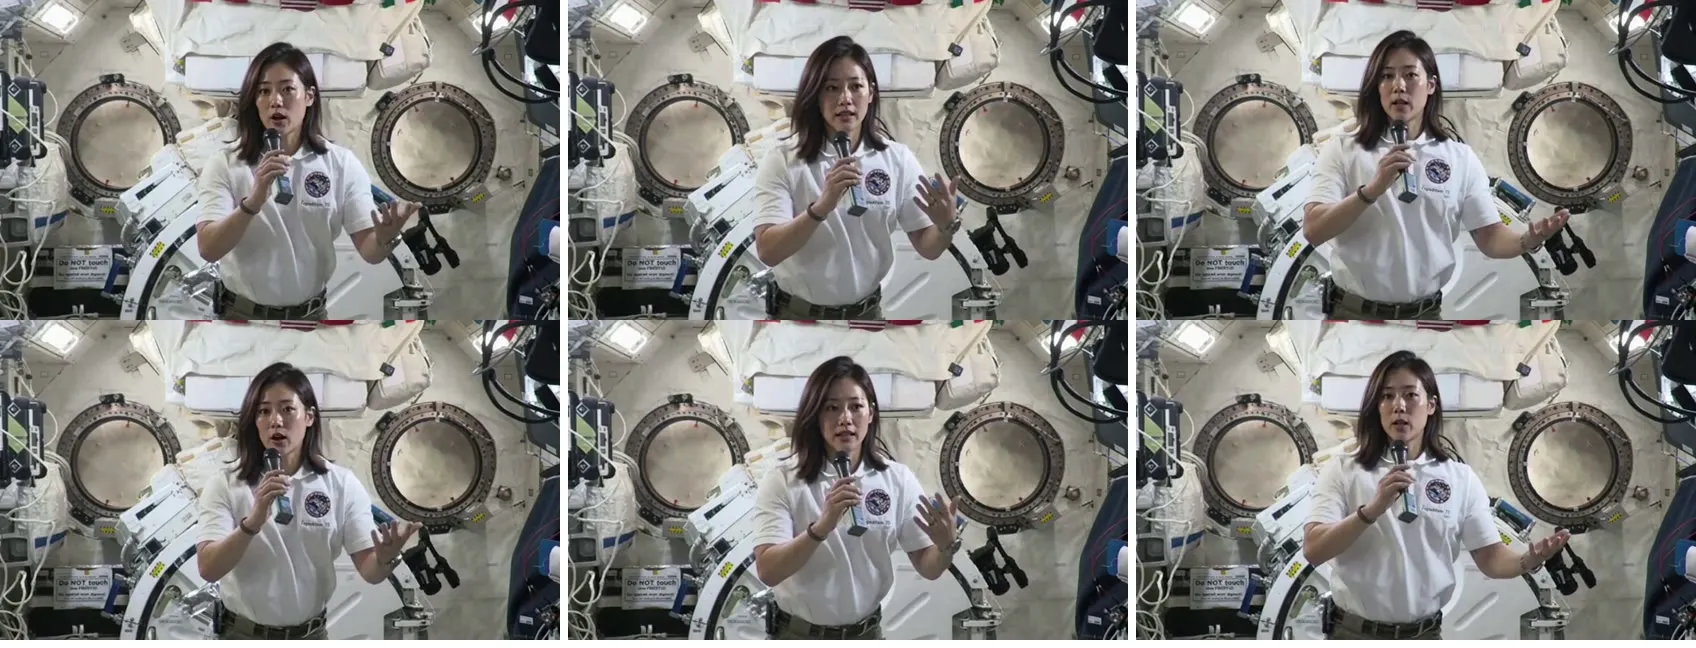
16개 결과 모두 1344×768, 24fps, 124프레임으로 나왔습니다. 같은 시드끼리 놓고 보면 두 곳의 결과가 사실상 겹쳤습니다. 이 글의 시간 비교는 같은 결과물을 만드는 데 걸린 시간을 비교한 것입니다.
요청 16번, warm은 고르고 cold는 흔들렸다
아래 그림의 점 하나가 요청 하나입니다. 시간은 같은 Mac에서 요청을 보낸 순간부터 완료를 확인한 순간까지입니다.
Runpod warm
Runpod cold
Comfy API warm
Comfy API cold
표로 보기
| 구분 | Runpod | Comfy API |
|---|---|---|
| warm 5회 | 250.5 / 196.2 / 198.2 / 196.3 / 195.7초 | 164.6 / 165.1 / 165.1 / 167.4 / 164.8초 |
| warm 중앙값 | 196.3초 | 165.1초 |
| cold 3회 | 221.9 / 221.8 / 371.2초 | 193.9 / 418.8 / 191.3초 |
| cold 생성 전 대기 | 24.8 / 1.3 / 145.2초 | 14.1 / 229.4 / 11.3초 |
워커가 떠 있을 때(warm) 연달아 보낸 요청은 Runpod 196.3초, Comfy API 165.1초가 중앙값이었습니다. Runpod의 첫 warm 요청 하나만 다른 워커가 받아 250초가 걸렸고, 나머지는 양쪽 모두 1~2초 안에 모였죠. 매번 약 30초씩 차이 났다는 뜻입니다.
cold는 요청 직전에 실행 중인 워커가 0인지 확인하고 보냈습니다. 그런데도 두 곳 모두 금방 다시 뜨는 대기 자리를 하나씩 들고 있었는데요. 그 자리가 바로 살아나면 대기가 몇십 초에 그쳤고, 새 GPU를 처음부터 잡으면 2~4분이 걸렸습니다. 세 번으로는 어느 쪽 cold가 더 빠르다고 말하기 어렵고, 두 곳 모두 첫 요청이 3분에서 7분 사이로 흔들릴 수 있다고 보는 편이 맞습니다.
참고로 Comfy API의 응답에서 상태 값은 제출 2초 뒤부터 running이었지만, 실제 생성 시작 시각은 5분 뒤인 경우도 있었습니다. 대기 시간을 재려면 상태 값 대신 작업의 started_at을 봐야 합니다.
warm 30초 차이는 샘플링 밖에서 났다
warm 차이가 너무 고르게 나와서 양쪽 ComfyUI 로그를 비교했습니다. Runpod 쪽은 같은 시드로 한 번 더 보내면서 워커 로그를 받았습니다.
표로 보기
| 실행 | 샘플링 | 그 외 ComfyUI | 합계 |
|---|---|---|---|
| Comfy API | 133.4초 | 25.3초 | 158.7초 |
| Runpod · US-NC-2 | 132.7초 | 35.3초 | 168.0초 |
| Runpod · US-MO-2 | - | - | 186.9초 |
생성의 핵심인 샘플링 4스텝은 양쪽 모두 약 133초(스텝당 33초)로 같았습니다. 약 9초는 샘플링 앞뒤의 VAE·텍스트 인코딩 구간에서 났는데요. 시작 로그를 나란히 놓으니 ComfyUI 0.41.0, GPU, attention 설정은 같고 torch만 달랐습니다. 제 이미지는 torch 2.9.1이라 ComfyUI가 working around nvidia conv3d memory bug 우회 경로를 켜는데, torch 2.12.1인 Comfy API 쪽에는 이 줄이 없었습니다. 영상 VAE가 3D 합성곱을 쓰니 가장 유력한 원인이지만, torch를 올려 다시 재 보지는 않았습니다.
나머지 약 19초는 GPU 서버 차이였습니다. warm 5회를 모두 처리한 워커(US-MO-2)는 ComfyUI 실행에 약 187초를 썼는데, 같은 요청을 다른 워커(US-NC-2)에서 다시 돌리자 168초가 나왔죠. 핸들러가 하는 입력 준비와 base64 처리는 약 2초로 작았습니다.
1.3배 단가와 요청당 비용
RTX PRO 6000 96GB ×1.30
H100 80GB ×1.30
H200 141GB ×1.30
B200 180GB ×1.30
표로 보기
| GPU | Comfy API | Runpod |
|---|---|---|
| RTX PRO 6000 96GB | $4.54/h | $3.49/h |
| H100 80GB | $6.23/h | $4.79/h |
| H200 141GB | $7.71/h | $5.93/h |
| B200 180GB | $11.23/h | $8.64/h |
| 네트워크 저장 공간 | $0.20/GB·월 | $0.07/GB·월 (1TB 미만) |
같은 GPU의 시간당 단가는 네 종류 모두 정확히 1.3배 차이 났습니다. Comfy API에서 고를 수 있는 GPU는 이 네 종류뿐이고, 가장 작은 것이 96GB입니다. 모델 저장 공간은 Comfy API가 $0.20/GB/월, Runpod Network Storage가 $0.07/GB/월(1TB 미만)이고, Comfy API는 Standard($20/월)부터 유료 플랜에 가입해야 쓸 수 있습니다.
warm 1건 계산값 생성 시간 × 단가
실제 청구 건당 평균 Comfy 9건 $2.29 · Runpod 10건 $2.14
표로 보기
| 항목 | Comfy API | Runpod |
|---|---|---|
| warm 1건 계산값 | 161초 × $4.54/h = $0.203 | 189초 × $3.49/h = $0.183 |
| 실제 청구 (다음 날 조회) | 9건 $2.29 (크레딧 484) | 10건 $2.14 |
| 건당 평균 | $0.254 | $0.214 |
warm 요청 하나를 실행 시간 × 단가로 계산하면 Runpod 189초는 약 $0.183, Comfy API 161초는 약 $0.203입니다. 단가는 30% 비쌌지만 생성이 빨랐던 만큼 차이가 11% 정도로 줄었죠. 다음 날 조회한 실제 청구액은 Runpod 10건 $2.14, Comfy API 9건 $2.29로, 건당 평균은 $0.214와 $0.254였습니다. 여기에는 cold 기동, 유휴 시간, 저장 공간이 함께 들어 있습니다.
환경 관리를 맡길지, GPU와 비용을 쥘지
커스텀 노드나 모델 버전 관리가 가장 손이 많이 간다면 Comfy API부터 써 보길 권합니다. Release가 불변이라 테스트한 환경이 그대로 배포되고, 이번 H3처럼 모델이 큰 워크플로도 CLI 몇 줄로 엔드포인트까지 갔습니다. 다만 모델 출처를 채우고 맞는 파일을 고르는 일은 직접 해야 했습니다.
반대로 24~48GB급 GPU로 충분한 워크플로이거나, 요청·응답 형식을 직접 바꿔야 하거나, ComfyUI 말고 다른 작업도 같은 곳에서 돌린다면 Runpod에 직접 올리는 편이 낫습니다. Comfy API의 가장 작은 GPU가 96GB라서 가벼운 워크플로일수록 단가 차이가 1.3배보다 커지기 때문이죠.
이번처럼 96GB가 필요한 무거운 워크플로라면 요청당 비용 차이는 크지 않았습니다. 이 경우에는 이미지의 torch 버전과 의존성을 직접 최신으로 유지할 시간이 있는지를 먼저 따져 보고 고르면 됩니다. 이번에도 오래된 torch가 요청마다 약 9초를 더 쓰게 만든 것으로 보였거든요.
같은 기준으로 따라 해보기
측정 스크립트와 그래프, Comfy API Build 스펙, 개별 실행값은 OMG Runpod Media의 Comfy API vs Runpod 레시피에 모아뒀습니다. 글의 근거를 나중에도 확인할 수 있도록 특정 커밋에 연결했습니다.
README.md에서 두 환경의 조건과 모델 라이선스를 확인합니다. 모델 파일과 입력 영상·사진은 저장소에 없습니다.comfy-build/의 스펙으로 Comfy API에 Build·Release·Deployment를 만듭니다.scripts/run_matrix.py --dry-run으로 실행 순서를 확인한 뒤, cold 3회·warm 5회를 돌립니다.- 결과는
benchmark-output/에 쌓이고, 이 글의 값은results/runs.csv에 있습니다.
Runpod 쪽 측정 스크립트는 제가 만든 핸들러의 입력 형식을 가정하므로, 직접 구축한 엔드포인트에 맞게 요청 형식을 고쳐 써야 합니다. 측정이 끝나면 Comfy API의 Deployment와 Build를 모두 지워야 저장 공간 과금이 멈춥니다.