H3로 영상을 만들 때 저는 Turbo LoRA를 거의 켜 두고 씁니다. 넣으면 빨라지니까 그냥 썼는데요. 쓰다 보니 궁금해졌습니다. 20 step을 4 step으로 줄이는데 어떻게 결과가 나오는 걸까요?
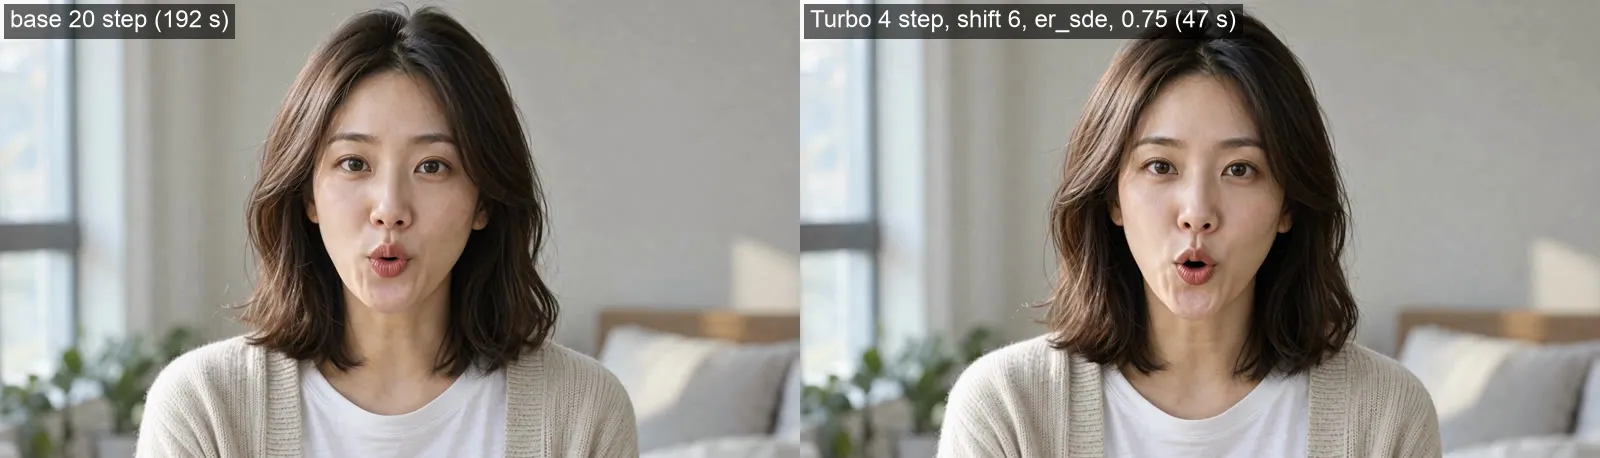
그래서 공개된 자료를 찾아보고, RTX PRO 6000 한 장에서 Turbo LoRA를 켜고 끄며 26편을 만들어 비교했습니다. 같은 첫 프레임과 같은 프롬프트로, 대사 한 줄을 말하는 5초 인물 영상입니다.
| 조건 | 생성 시간 (모델 로딩 후, 요청 → 저장) |
|---|---|
| 기본 20 step | 192–202초 |
| Turbo 4 step | 47–49초 |
화질은 비슷했고, Turbo 쪽이 표정과 입 움직임이 더 컸습니다. 소리는 20 step이 조금 더 깨끗했습니다. 아래에서 왜 이런 차이가 나는지, 어떤 조건에서 Turbo가 잘 동작하는지 차례로 보겠습니다.
실험 조건
| 항목 | 값 |
|---|---|
| GPU | Runpod RTX PRO 6000 Blackwell Server Edition × 1 |
| 모델 | MiniMax H3 FL2VA (ComfyUI 배포본, pruned INT8) |
| LoRA | lightx2v/Minimax-h3-Turbo, 4-step v1.0·v1.1·v1.2 768p, 8-step v1.0 768p |
| 출력 | 1344×768, 124프레임, 24fps (약 5.2초), 영상 + 소리 |
| 기본 설정 | 샘플러 res_multistep, 스케줄러 simple, CFG 없음(BasicGuider) |
| 반복 | 조건마다 1회. seed 비교만 seed 4개 |
판정은 영상과 소리를 나란히 보고 들으면서 제가 직접 했습니다. 소리는 이름을 가리고 순서를 섞어서 들었습니다. 장면 하나로 본 결과라 다른 장면에서는 다를 수 있습니다.
step마다 모델이 예측한 결과
생성 모델은 매 step마다 노이즈가 섞인 지금 상태(x_t)를 받아서, 노이즈를 다 걷어냈을 때의 최종 결과를 예측합니다. 이 예측을 x0라고 부릅니다. 샘플러는 x0까지 한 번에 가지 않고 그쪽으로 조금만 이동한 뒤, 다음 step에서 다시 예측합니다. H3 같은 flow matching 모델은 속도 v를 예측하는데, 지금 노이즈 양 σ를 알면 x0 = x_t − σ·v로 바로 계산할 수 있습니다.
이 x0를 step마다 저장해서 영상으로 디코딩해 봤습니다.
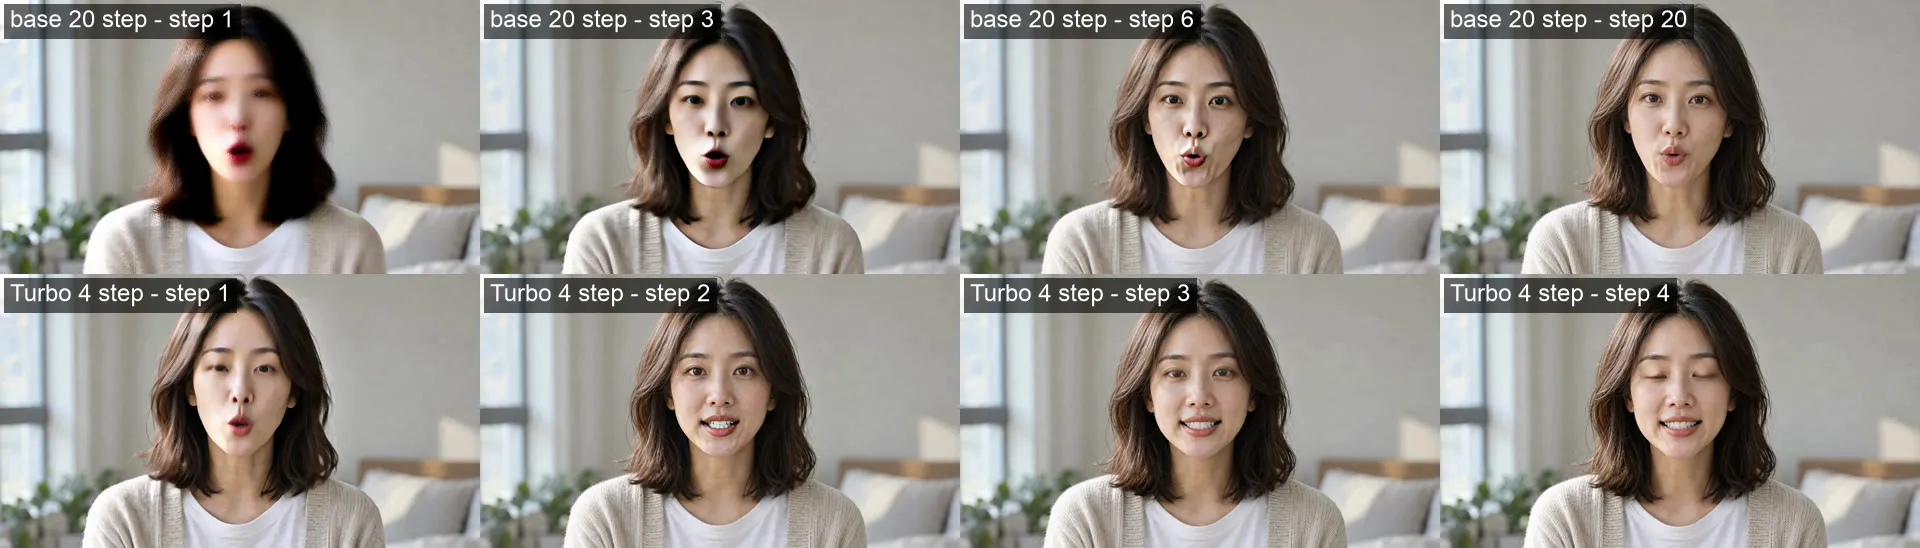
기본 모델의 첫 step x0는 뭉개진 평균 얼굴입니다. 입력이 거의 노이즈뿐이라 가능한 결과들의 평균을 내놓는 셈입니다. 얼굴 형태는 6~10 step 사이에 잡히고, 나머지 step은 디테일을 채웁니다.
Turbo는 첫 step부터 눈, 코, 입 위치가 잡혀 있습니다. 완성본은 아니지만 평균이 아니라 하나의 얼굴을 이미 고른 상태입니다. 같은 과정을 빨리 도는 게 아니라, step 하나가 맡는 노이즈 구간 자체가 넓어진 것이죠. 그림에서 보듯 Turbo는 step 사이에 표정이 바뀌기도 했습니다.
참고로 H3는 공개 가중치부터 CFG 증류가 되어 있어서(README), 원래부터 step마다 forward가 한 번입니다. Turbo가 새로 줄인 것은 step 수입니다. step당 약 8.7초, 텍스트 인코딩과 VAE 디코딩 같은 고정 비용이 약 13초여서, 20 step → 4 step이 5배가 아니라 약 4배 차이로 나타났습니다(두 측정값으로 역산한 추정).
Turbo LoRA는 어떻게 학습될까
H3 Turbo LoRA는 LightX2V 팀이 만들었습니다. 저장소 설명은 “Distill Minimax-H3 into 4 steps” 한 줄이고, 학습 방법은 공개하지 않았습니다. 대신 같은 팀이 Wan 2.1용 4 step 모델을 만든 방법은 문서로 공개되어 있어서, 여기서는 그 방법으로 해석합니다. H3에도 같은 방법을 썼다는 보장은 없습니다.
DMD: 결과의 분포를 맞추는 증류
방법은 DMD(Distribution Matching Distillation)입니다. 모델 세 개가 들어갑니다.
| 모델 | 역할 |
|---|---|
| generator | 4 step으로 결과를 만드는 모델(학습 대상) |
| real score | 원본 모델. 고정 |
| fake score | generator가 지금 만드는 결과의 분포를 계속 따라 학습 |
generator의 결과에 노이즈를 다시 섞어 두 score 모델에 넣으면, 각자 노이즈를 걷어낼 방향을 내놓습니다. 두 방향의 차이가 generator를 업데이트하는 gradient가 됩니다. 원본이 거치던 경로를 step마다 따라가는 대신, generator 결과의 분포가 원본 분포와 같아지도록 맞추는 방식입니다. 그래서 step을 크게 줄여도 결과가 원본 분포 안에 들어갑니다.
이때 줄이는 값은 KL(쿨백-라이블러 발산)입니다. 두 분포가 얼마나 다른지를 재는 값인데, 어느 쪽을 기준으로 재느냐에 따라 달라집니다. DMD는 generator 결과를 기준으로 재는 reverse KL을 줄입니다. generator가 원본 분포에 없는 결과를 내면 값이 크게 오르지만, 원본 분포의 일부를 아예 만들지 않는 것은 값에 거의 반영되지 않습니다. 그래서 generator는 가장 그럴듯한 쪽으로 몰리고, 결과의 다양성이 줄어들 수 있습니다.
LightX2V 문서에 따르면 이들은 DMD2를 따라 회귀 손실을 빼고, 대신 원본 모델 결과로 generator를 먼저 초기화합니다. 학습 코드는 Self-Forcing을 고친 것이라 학습 중에도 generator가 직접 만든 결과를 입력으로 씁니다.
고정된 노이즈 위치
Wan용 4 step 모델에서 generator가 거치는 노이즈 위치는 denoising_step_list: [1000, 750, 500, 250]으로 고정되어 있고, 문서는 학습 때 쓴 값이므로 바꾸지 말라고 안내합니다. 이 네 위치에서 다음 위치로 건너뛰는 것만 학습한다는 뜻입니다. 다른 위치에서 시작하거나 step 수를 바꾸면 학습에 없던 구간을 맡게 됩니다.
LoRA 파일 구조
H3 Turbo LoRA 파일의 safetensors 헤더를 직접 열어 봤습니다.
| 항목 | 값 |
|---|---|
| 학습 rank / alpha | 128 / 128 (v1.2는 alpha 8) |
| 적용 위치 | 트랜스포머 블록 50개 전부의 어텐션 qkv·출력, MLP. token refiner 일부 |
| 파라미터 | 약 0.98B (본체 33B의 약 3%) |
| 메타데이터 | source_format: Diffusers PEFT LoRA, base_model: Comfy-Org/MiniMax-H3 minimax_h3_fl2va_bf16 |
학습 단계부터 LoRA로 학습한 파일입니다. LoRA 강도를 0.75로 주면 이 증류 변화량의 75%만 더하는 것이므로, 원본과 증류된 모델 사이의 중간 지점을 쓰게 됩니다.
학습 조건을 벗어나면
step 수
| LoRA | 실행 step | 결과 |
|---|---|---|
| 4-step | 2 | 흐려짐 |
| 4-step | 4 | 입 모양 어색, 얼굴 변형 |
| 4-step | 8 | 얼굴 변형 |
| 8-step | 4 | 흐려짐 |
| 8-step | 8 | 괜찮음 |
(shift 12 조건에서 실행)
둘 다 8 step으로 돌렸을 때 8-step LoRA는 괜찮았고, 4-step LoRA는 얼굴이 변했습니다. step을 늘린다고 좋아지지 않았습니다. step 수는 품질 옵션이 아니라 LoRA마다 정해진 값으로 보는 게 맞습니다. 4-step LoRA를 4 step으로 돌렸는데도 결과가 나빴던 이유는 바로 아래 shift에 있었습니다.
shift
노이즈 100%에서 0%까지 4번에 나눠 갈 때, 어디서 끊을지를 shift가 정합니다. shift가 클수록 노이즈가 많은 쪽에서 잘게 끊습니다. ModelTC README에 따르면 768p Turbo LoRA는 video shift 6, audio shift 3으로 학습했습니다. 그런데 ComfyUI H3 템플릿은 원본 모델 기본값인 12를 쓰기 때문에, LoRA만 끼우면 shift 12로 실행됩니다.
README의 식(σ = s·q / (1 + (s−1)·q), q = [1, 0.75, 0.5, 0.25])으로 4 step의 노이즈 위치를 계산하면 다음과 같습니다.
| shift | step 1 | step 2 | step 3 | step 4 | 마지막 구간 |
|---|---|---|---|---|---|
| 6 (학습 조건) | 1.000 | 0.947 | 0.857 | 0.667 | 0.667 → 0 |
| 12 (ComfyUI 기본) | 1.000 | 0.973 | 0.923 | 0.800 | 0.800 → 0 |
shift 12에서는 네 번 중 세 번을 노이즈 90% 이상 구간에서 쓰고, 마지막 한 번에 80%에서 0%까지 가야 합니다. 학습 때는 67%에서 출발한 구간입니다.
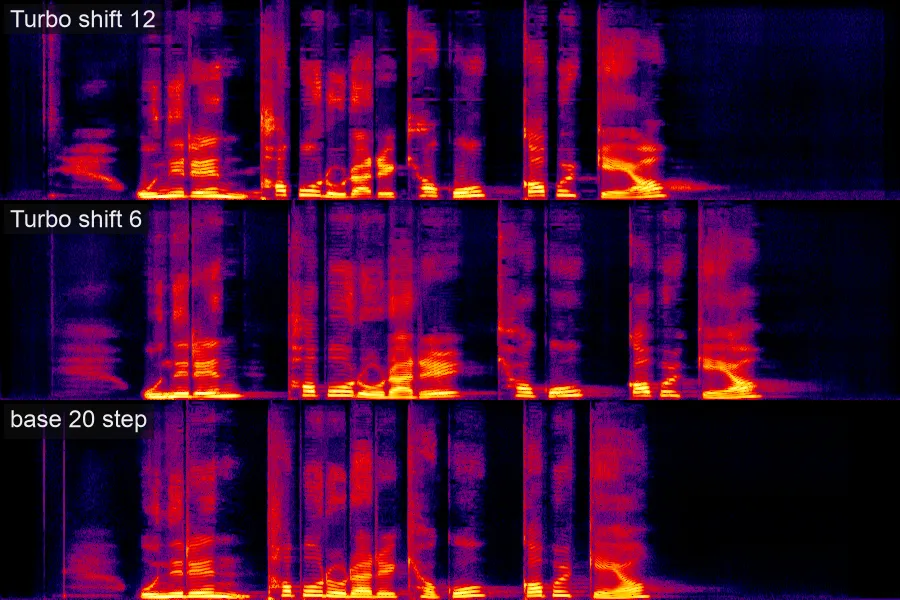
shift를 12에서 6으로 바꿨을 때 가장 크게 달라진 것은 소리였습니다. 이름을 가리고 들었을 때 잡음·자연스러움 점수(5점 만점)가 2 / 3에서 4 / 4가 되었고, 대사가 끝난 뒤 깔리던 잡음이 줄었습니다. 기본 모델 20 step은 5 / 5였습니다. 오디오 shift는 두 조건 모두 3이어서, 소리가 좋아진 원인까지는 확인하지 못했습니다. 화면은 shift만 바꿨을 때 조금 나아지는 정도였습니다.
샘플러와 강도
| shift 6 조건 | 결과 |
|---|---|
| res_multistep, 강도 1.0 | 입 모양 어색 |
| euler, 강도 1.0 | 소리 잡음, 목소리 어색 |
| er_sde, 강도 1.0 | 입 모양 어색 |
| lcm, 강도 1.0 | 목소리 어색 |
| er_sde, 강도 0.75 | 괜찮음 |
| (참고) LoRA 없이 4 step | 괜찮음 (목소리는 어색) |
화면은 샘플러와 강도의 영향이 더 컸습니다. Kijai가 ComfyUI 변환본에 추천한 조합인 er_sde에 강도 0.75만 입 모양이 자연스러웠고, LoRA 없이 4 step으로 돌린 결과보다 나았습니다.
다양성과 표정
seed만 바꿔서 기본 20 step과 Turbo 4 step을 4편씩 만들었습니다(shift 12 조건). 기본 모델 쪽이 서로 더 달랐고, 프레임 간 평균 픽셀 차이로 재 보면 seed끼리의 차이가 Turbo 쪽이 약 10% 작았습니다(10.3 / 9.3). 반대로 프레임 사이 움직임은 Turbo가 더 컸고(0.92–1.19 / 1.31–1.61), 표정이 더 과장되어 보였습니다. shift 6으로 맞춘 결과에서도 움직임 수치는 1.46–1.67로 비슷하게 컸습니다.
reverse KL이 가장 그럴듯한 쪽으로 몰린다는 성질과 같은 방향의 결과입니다. 다만 seed 4개, 장면 하나라 근거로는 약하고, H3 Turbo에서 그 성질 때문이라고 확인한 것은 아닙니다.
정리: 제가 쓰는 설정
| 용도 | 설정 | 시간 |
|---|---|---|
| 초안 | Turbo 4-step v1.0 768p, ModelSamplingMiniMaxH3(shift 6 / 3), er_sde, LoRA 강도 0.75 |
약 47초 |
| 최종 | Turbo 끄고 기본 20 step | 약 192초 |
초안은 Turbo로 여러 번 뽑아 구도와 움직임을 고르고, 고른 것만 Turbo를 끄고 20 step으로 다시 뽑습니다. 소리와 표정은 아직 20 step이 낫습니다.
ComfyUI에서 Turbo LoRA를 쓰고 있다면, ModelSamplingMiniMaxH3 노드로 shift가 학습 조건과 맞는지부터 확인해 보세요. 544p로 학습한 LoRA(4-step v0.1, 8-step v1.0)는 README 기준 shift 12 / 3이 학습 조건입니다.
실험 스크립트, step별 x0를 저장하는 커스텀 노드, 위 두 설정의 ComfyUI 워크플로, 실행별 시간과 수치는 OMG Runpod Media의 07 레시피에 정리했습니다.